为什么不能直接按热度统计?从查询文本到独立问题的转化难题
直接按热度统计无法解决从原始查询到独立 FAQ 选题的转化难题,因为数据本身缺乏判定何时合并或拆分问题的端到端流程。
FAQ 选题的瓶颈从来不是发现零散问题,而是判定何时值得将其独立成篇 [1][2]。你手头可能有搜索日志、Zendesk 指标和 TicketHub 摘要,这些数据能告诉你用户搜了什么、点击率多少、建单数几何,甚至能按语言或角色切片 [3][2]。但数据本身不会自动告诉你:这三个高热度词该合并成一个问题,还是该拆成三个独立条目?这些来源缺乏从原始查询到独立 FAQ 选题的端到端流程 [3][1][2]。
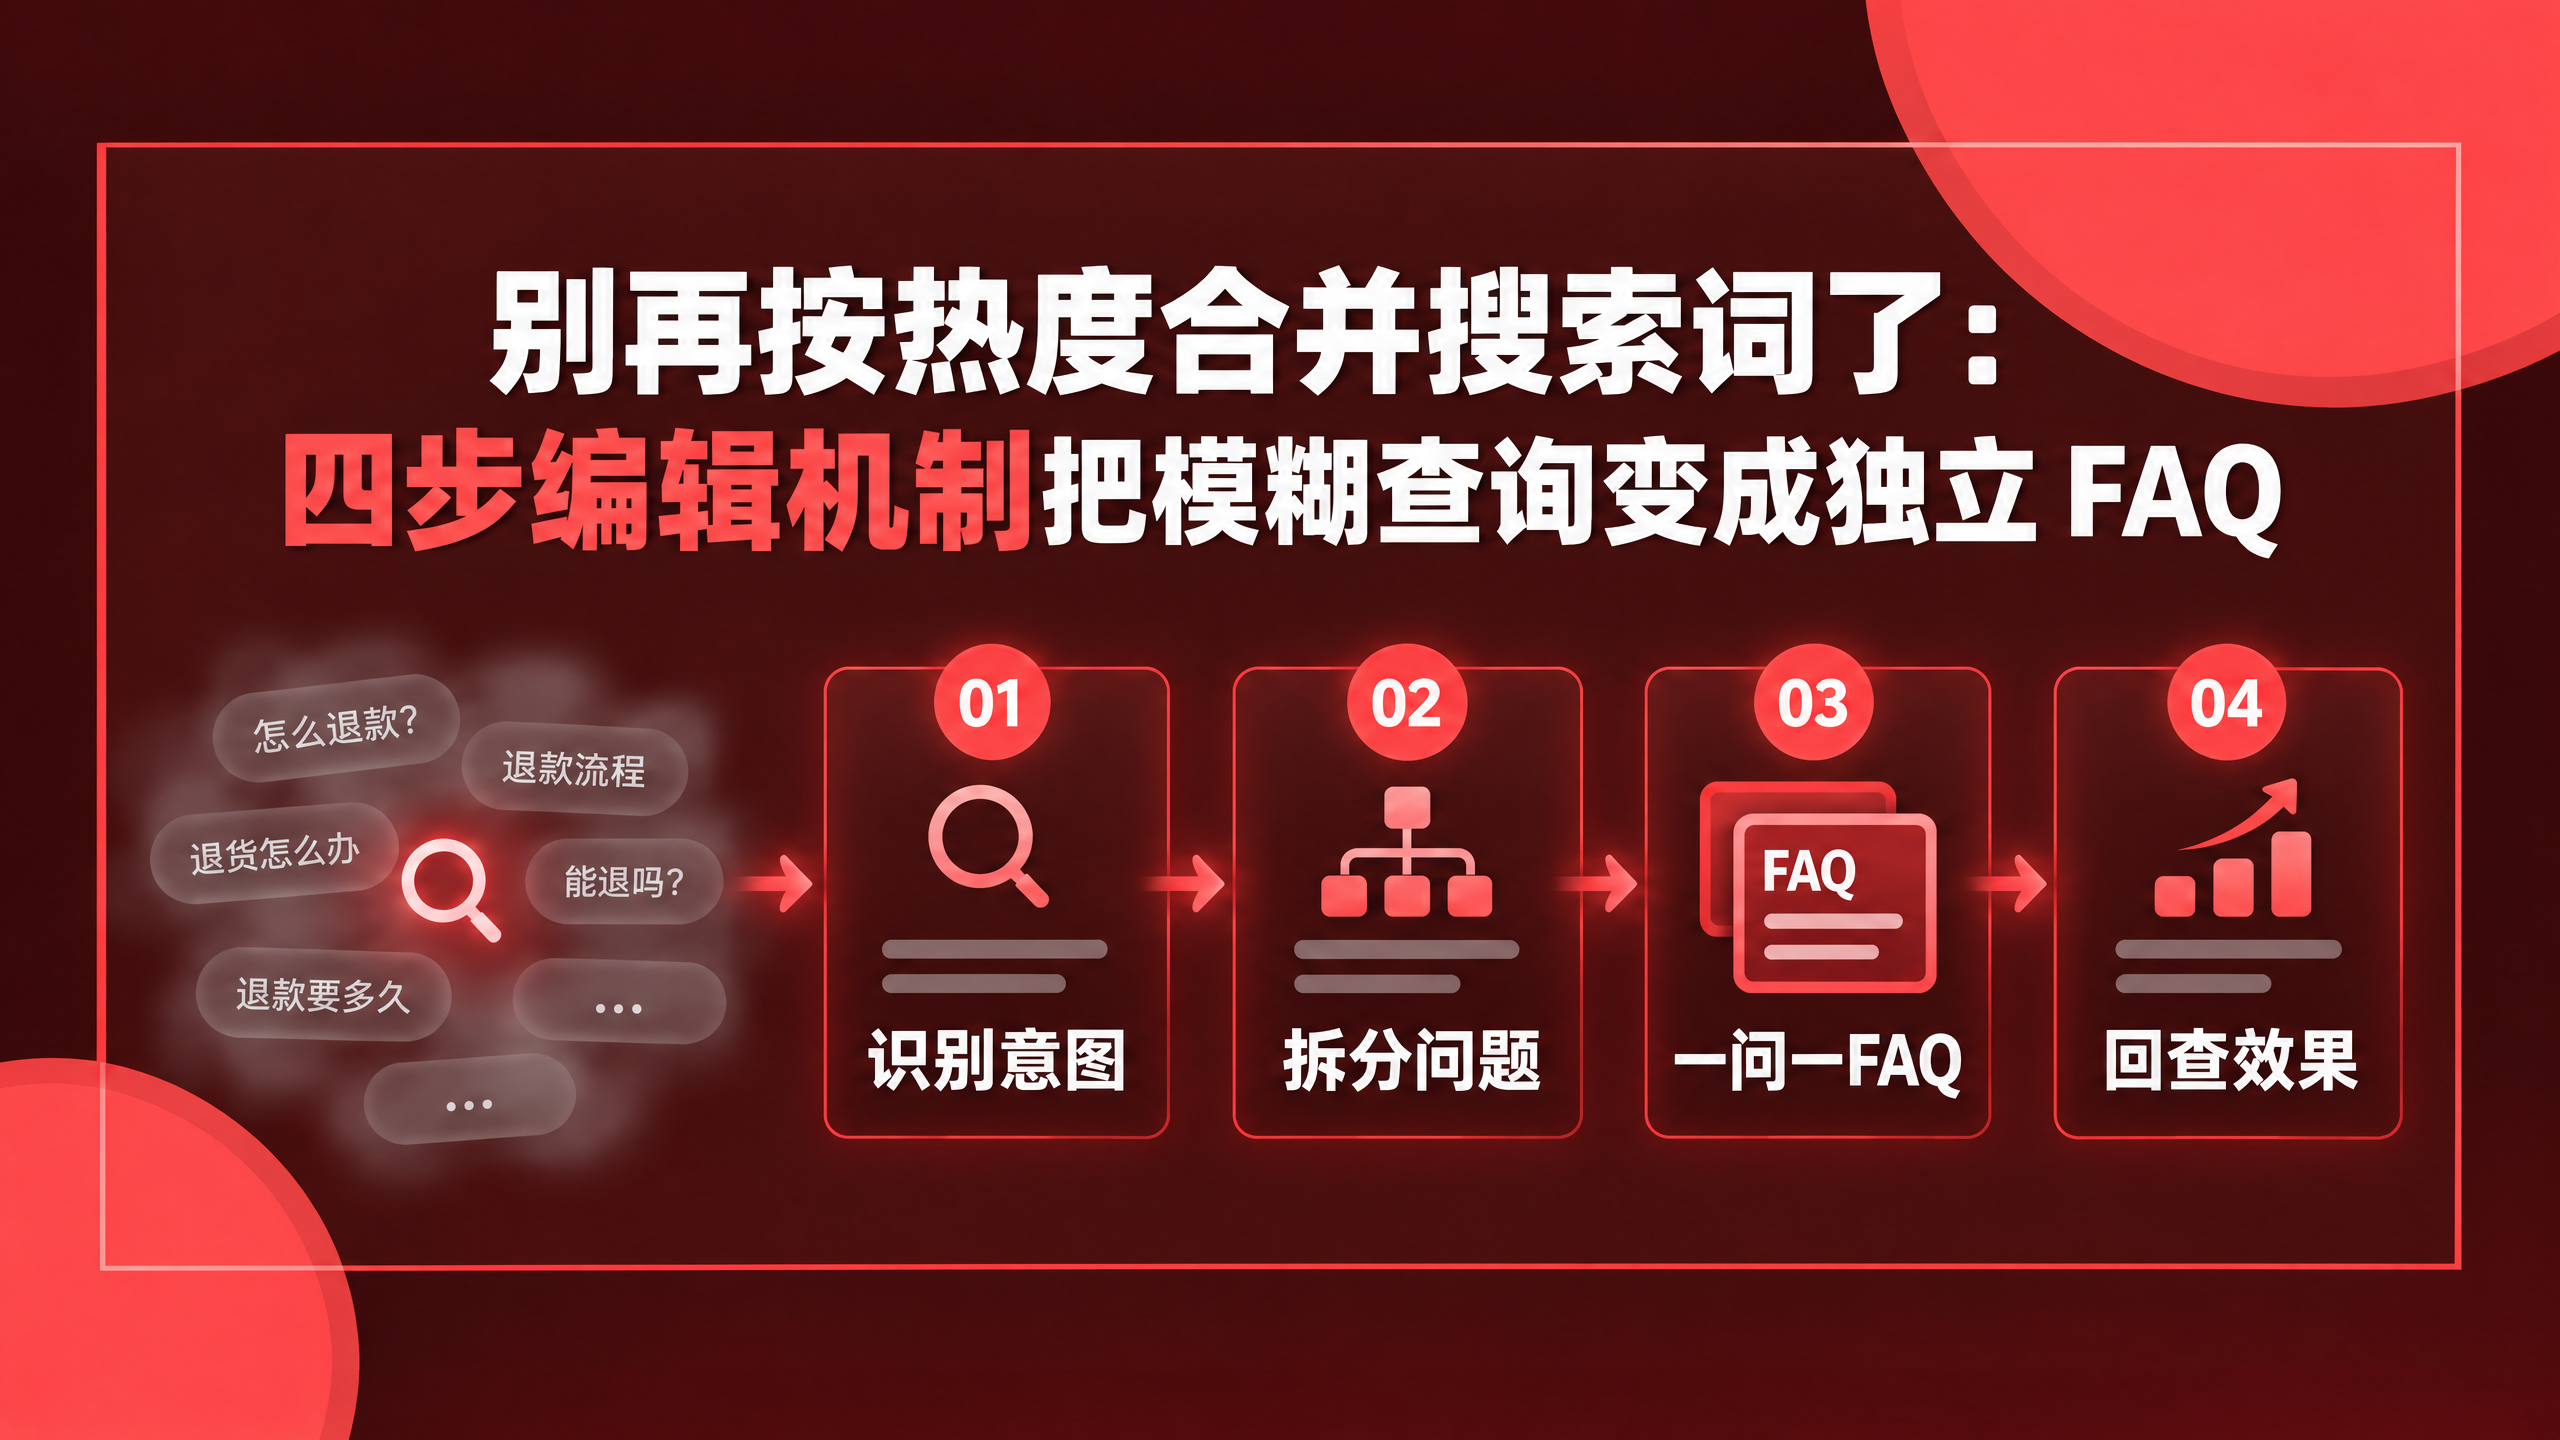
本文提出的四步法,是一个受证据约束的编辑机制,而非已被验证的行业标准规范 [4]。它的核心任务很明确:把你看到的模糊查询文本,转化为结构清晰、可维护的问题单元。别指望系统自动完成这一步,你需要亲手把混乱的搜索词梳理成独立的逻辑单元。
新手最容易在这里栽跟头: 很多人试图直接用“搜索量”作为合并的唯一依据,结果把“怎么设置”(操作)和“设置失败”(故障)混在一起。因为两者在日志里可能都指向同一个功能按钮,导致最终生成的文章既教了操作又没解决报错,两头不讨好。避免方法很简单: 在合并前,先人工快速扫描这组词的“意图分布”,只要看到哪怕一条包含“无法”、“错误”字眼的记录,就立刻将其从“操作类”池中剥离,单独进入故障处理流程,而不是为了凑热度强行合并。
第一步:同义词映射与拼写差异归一化
同义词映射与拼写差异归一化是将写法不同但含义相近的搜索词合并为同一个可维护问题单元的基础步骤。
读完这篇,你能把一堆长得像但写法不同的搜索词,合并成同一个可维护的问题单元。
核心动作是“归一化”:把所有变体——同义词、拼错的字、产品旧称、新名甚至外语表达——全部指向一个候选问题 [1][5]。别被自动补全(autocomplete)骗了。系统推荐出来的改写词,往往只是算法的猜测,不代表用户原本想说的话,直接拿来当原始语言会扭曲统计结果 [5]。只有统一术语,才能剔除重复计数,让不同来源的相似查询真正聚合在一起。
如何处理产品新旧名称和多语言表达
建立词汇表是解决迭代混乱的关键。把产品迭代中的旧称和新名强制关联,确保无论用户搜哪个版本的名字,都算作同一个对象。遇到多语言或方言时,识别出它们描述的是同一概念,直接合并处理,避免人为割裂数据。
这一步做到合格的标准:
同一产品的不同历史名称已录入映射表
拼写错误已被修正为正确术语
不同语言的同类查询已归并为单一条目
自动补全建议未被当作原始用户输入采纳
照着做就行:
[ ] 列出所有产品别名并建立双向链接
[ ] 扫描日志中的常见拼写错误并修正
[ ] 检查非英文/非本地化查询是否重复
[ ] 排除自动补全生成的伪需求
第二步:意图分离与第三步:对象精准定位
意图分离与对象精准定位旨在将模糊搜索拆分为具体行为、原因及场景三类独立问题,并明确角色、地区等关键标签。
读完这一节,你能把一堆模糊的搜索词拆成“做什么”、“为什么错”和“在哪设”三类独立问题,并给每个问题贴上具体的角色、地区或渠道标签。别再让不同需求挤在同一个标题里,那样写出的 FAQ 谁都用不上。
按核心动作拆解意图
用户搜出来的词往往混杂着完全不同的目的。有人问“怎么导出”,是想要操作教程;有人问“导不出怎么办”,是在报故障;还有人问“导出按钮在哪”,需要配置指引。这三者必须分开处理,不能因为关键词相似就合并[6][4]。
合格标准清单:
操作类:明确包含“如何”、“步骤”、“设置”等动词导向词。
故障类:明确包含“失败”、“报错”、“无法”、“错误代码”等否定词。
配置类:明确指向位置、开关、权限或特定参数。
用平台数据锁定具体对象
同一个功能在不同人眼里是完全不同的问题。新手和老手遇到的障碍不同,国内用户和海外用户的界面语言也不同。利用 Zendesk 搜索分析中的 User role(用户角色)、Locale(语言/地区)、Search channel(搜索渠道)等过滤维度,能帮你把通用问题切分成细颗粒度的单元[2]。
不要只盯着总搜索量。如果某个功能在“管理员”角色下的咨询量很高,而在“普通用户”下几乎为零,这就说明该问题的受众极其精准,必须单独成篇。同样,Web 端和 App 端的操作流程差异巨大,混在一起只会让用户找不到路。
场景细分检查表:
角色差异:是否区分了管理员与普通用户的操作路径?
地区差异:是否根据
Locale字段拆分了多语言版本的 FAQ?渠道差异:App 内搜索与官网工单系统的需求是否已做物理隔离?
通过这一步,你确保了同一个功能点在不同场景下都能生成独立的条目。这不仅是分类,更是为了后续维护时能快速定位到特定人群的真实痛点。
第四步:基于故障现象识别分类,拒绝单一热度指标
基于故障现象识别分类拒绝单一热度指标,通过拆解四种失败类型来解决用户“找不到”而非单纯“没搜索”的核心痛点。
别再盯着搜索量或点击率看单一数字了。那些数据只能告诉你“有人找”,却没法告诉你“为什么没解决”。真正的编辑动作发生在把四种失败类型拆开处理时[7]。
先把日志里的异常行为归类,再决定怎么动笔。
无结果:用户搜不到任何内容。这是内容缺口,直接补充文章。
低点击:用户看到了列表但没点进去。说明标题或摘要没击中痛点,需重写引导语。
搜索后建单:用户搜完还是去提工单。这代表现有方案失效,必须检查产品逻辑。
重复工单:同一问题反复出现。别急着写 FAQ,先排查是不是产品缺陷。
这种分法不是行业标准,而是帮你拆解决策的辅助工具[4]。它让你看清每个搜索词背后的真实意图,而不是被笼统的热度掩盖。
最后,利用 TicketHub 的摘要功能验证你的判断。如果多个相似工单指向同一个解决方案,且趋势明显,才值得独立成篇。不要把所有高流量词都变成文章,只处理那些真正需要人工介入的故障场景。
本章执行清单
[ ] 将“无结果”“低点击”“搜索后建单”“重复工单”四类数据分开统计
[ ] 针对每类失败匹配对应的优化动作(补文/改题/查产品)
[ ] 用 TicketHub 摘要确认相似解决方案是否存在
[ ] 仅对具备独立解决价值的故障现象撰写新 FAQ
从理论到实践:构建可维护的 FAQ 选题工作框架
读完本章,你能立刻搭建一套从海量搜索日志中提炼独立问题的四步编辑流程。这套流程不依赖玄学,只靠四个具体动作串联起数据与内容。
把四步法跑通
先做归一化,把同义词、拼写错误或新旧产品名统一映射到同一个候选问题[1]。接着做意图分离,将“怎么做”和“为什么失败”拆成两条线处理[6]。随后锁定对象,利用平台数据把问题绑定到具体的角色、地区或渠道[2]。最后识别故障现象,区分无结果、低点击或重复建单,别把它们混在单一热度里[7]。
警惕标准陷阱
别把这当成行业标准。文献指出,分类体系(Taxonomy)只是设计前的辅助工具,能帮人分析决策,但不能直接证明 FAQ 必须按这四维切分[4]。你的框架是受证据约束的编辑机制,而非绝对真理[3]。就像用地图导航,它指路但不决定你走哪条路。
落地检查清单
实际操作时,对照这份清单确保每一步都到位:
[ ] 是否已合并所有拼写变体和旧称?
[ ] “做什么”和“为何错”是否已物理隔离?
[ ] 每个问题是否绑定了明确的受众标签?
[ ] 是否根据故障类型(如重复工单)单独设立了条目?
[ ] 是否预留了结合业务数据调整的空间?
这套方法的核心价值,在于解决从杂乱查询到结构化内容的转化效率。只要坚持按步骤执行,你就能把零散数据变成可维护的知识库单元。
GEO 增值视角:为生成式 AI 做好准备
实施这套四步法的价值不仅在于优化当前的工单系统,更在于为生成式引擎优化(GEO)打下坚实基础。未来的搜索将越来越依赖 AI 直接生成答案,而非单纯罗列链接。
你现在进行的看似枯燥的数据清洗工作,实际上是在为 AI 提供最优质的“语料”:
意图清晰,AI 不迷路:通过第二步将“操作指南”与“故障排除”物理隔离,能最大限度确保当用户向 AI 提问时,AI 不会错误地提取一个“如何设置”的片段去回答“为什么报错”的问题。清晰的意图边界是 AI 准确生成答案的前提。
归一化是精准匹配的基础:第一步完成的术语归一化,确保了无论用户使用俚语、旧称还是模糊描述向 AI 提问,AI 模型都能将其映射到标准的知识点上进行推理和回答。
做好前端的选题治理,后端的 AI 检索效率将事半功倍。
常见问题解答 (FAQ)
| 问题 | 解答 |
|---|---|
| 为什么要进行搜索日志归一化? | 因为原始数据中存在大量同义词、拼写错误和产品新旧名称的变体,直接统计会导致数据重复,无法反映真实的用户意图。归一化能将这些变体聚合,形成准确的问题单元。 |
| 如何区分“操作类”和“故障类”问题? | 关键在于动词和否定词。操作类通常包含“如何”、“步骤”、“设置”等正向指令;而故障类则包含“失败”、“报错”、“无法”等负面描述。两者必须物理隔离,分别撰写。 |
| 自动补全的建议词可以直接使用吗? | 不建议。自动补全是算法预测的结果,往往偏离用户原本的精确表述。直接使用会扭曲统计结果,正确的做法是将其视为参考,以用户实际输入的原始文本为准进行归一化。 |
| TicketHub 摘要在选题中起什么作用? | 它用于验证“搜索后建单”或“重复工单”背后的解决方案是否一致。如果多个相似工单指向同一方案,说明该问题具有高频共性,适合整理成独立 FAQ;否则可能是产品缺陷,需优先修复产品。 |
参考来源
Search-Log Analysis: The Most Overlooked Opportunity in Web UX Research - NN/G · https://www.nngroup.com/articles/search-log-analysis/(B级)
Analyzing help center search results · https://support.zendesk.com/hc/en-us/articles/4408818465562-Analyzing-help-center-search-results(B级)
TicketHub: Enabling Actionable Analysis of Support Requests With NLP · https://dl.acm.org/doi/fullHtml/10.1145⁄3569951.3604397(S级)
A Cognitively-Based Functional Taxonomy of Decision Support Techniques | ACM SIGCHI Bulletin · https://dl.acm.org/doi/10.1145⁄28189.1044805(S级)
Site Search Suggestions - NN/G · https://www.nngroup.com/articles/site-search-suggestions/(B级)
IntentsKB | Proceedings of the 27th ACM International Conference on Information and Knowledge Management · https://dl.acm.org/doi/10.1145⁄3269206.3269257(S级)
7 Ways to Improve Your Website’s or Intranet’s Built-In Search Engine - NN/G · https://www.nngroup.com/articles/internal-website-search/(B级)